参数化PINN:一条移动的色带,一族解
一条首尾相接、周长 1 米的传送带,带面上有深有浅。这个最小例子把输运方程里的波速 $c$ 也当成网络的输入:训练一次,就能查询任意波速下的解,而不必为每个 $c$ 单独训练一个网络。周期边界则用坐标映射硬约束住,省去额外的惩罚项。
物理方程
取一维输运方程:
$$ \frac{\partial u}{\partial t}+c \frac{\partial u}{\partial x}=0. $$
初始条件 $u(x,0)=u_0(x)=[1+\sin(2\pi x)]/2$,周期边界 $u(0,t)=u(1,t)$。
取 $0\le x\le 1.0$,$0\le t\le 0.5$,$0.2\le c\le 1.0$。这一族问题的参考解可以手算:$u_c(x,t)=u_0(x-ct)$,颜色只是随传送带整体平移,形状不变。
本例的重点在于把 $c$ 送进网络:$x,t,c$ 三个量都是输入,网络学的是整个解族 $u(x,t;c)$,而不仅仅是某一部“影片”。
网络构建
把一维空间坐标 $x\in[0,1]$ 映射到二维单位圆上:$x \mapsto \big(\cos(2\pi x), \sin(2\pi x)\big)$,由此构造硬约束周期边界条件(Hard-constrained Periodic BC):
$$ \cos(2\pi \times 0) = \cos(2\pi \times 1) = 1, \quad \sin(2\pi \times 0) = \sin(2\pi \times 1) = 0 $$
输入特征在 $x=0$ 和 $x=1$ 处完全重合,使得网络输出天然严格满足周期性:
$$ \hat{u}(0, t, c) \equiv \hat{u}(1, t, c) $$
这免去了在 Loss 中额外构建周期边界惩罚项的步骤。
时间变量归一化:4 * t - 1,把 $t\in[0,0.5]$ 线性映射到 $[-1,1]$。
参数化输运速度归一化:(c - 0.6) / 0.4,把 $c\in[0.2,1.0]$ 中心化并缩放到 $[-1,1]$,作为输入特征送入网络。
于是 4 个特征通道分别为:
$$ \mathbf{X}_{\text{in}} = \begin{bmatrix} \cos(2\pi x) & \sin(2\pi x) & \tilde{t} & \tilde{c} \end{bmatrix} $$
四个特征通道都被压在 $[-1,1]$ 内,处于 Tanh 激活函数导数最大、最灵敏的近线性区间,可防止神经元过早进入平坦饱和区引发梯度消失。
1 | import math |
网络训练
每一步按均匀分布随机抽取 $x, t, c$,由自动微分算出 PDE 残差,再单独抽一批点约束 $t=0$ 处的初始图案,并给初始损失 4 倍权重:
$$ \mathcal{L} = \underbrace{\frac{1}{N}\sum_i \left(\hat{u}_t + c \hat{u}_x\right)^2}_{\text{方程误差}} + 4 \underbrace{\frac{1}{N}\sum_j \left(\hat{u}(x_j,0,c_j)-\frac{1+\sin(2\pi x_j)}{2}\right)^2}_{\text{初始误差}} $$
1 | optimizer = torch.optim.Adam(net.parameters(), lr=0.002) |
运行输出:
| 步数 | 方程误差 | 初始误差 |
|---|---|---|
| 1 | 3.10e-02 | 2.04e-01 |
| 2500 | 2.47e-03 | 1.30e-04 |
| 5000 | 8.64e-04 | 5.88e-05 |
预测与可视化
固定 $t=0.5$ s,让同一个网络依次预测 7 个波速下的颜色曲线,并与解析解 $u_0(x-ct)$ 对照。由于 $c$ 只是一列输入,换波速不需要重新训练:
1 | speeds = [0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9] |
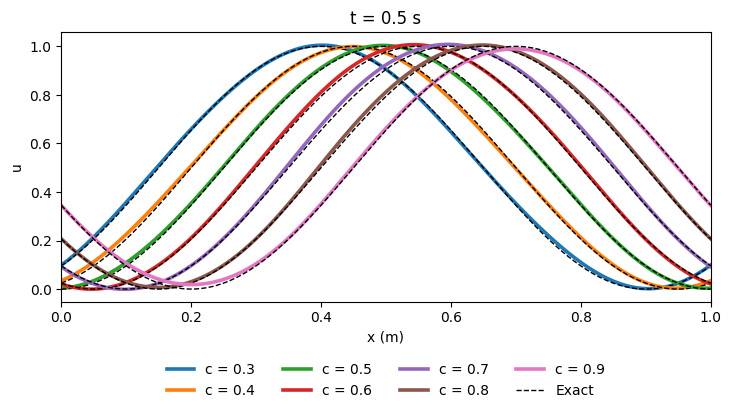
实线为网络预测,黑色虚线为解析解;波速越大,峰值越靠右。
| 带速 | 预测峰位 (m) | 手算峰位 (m) | 颜色平均绝对误差 |
|---|---|---|---|
| 0.3 | 0.400 | 0.400 | 0.0056 |
| 0.4 | 0.450 | 0.450 | 0.0068 |
| 0.5 | 0.495 | 0.500 | 0.0058 |
| 0.6 | 0.545 | 0.550 | 0.0063 |
| 0.7 | 0.595 | 0.600 | 0.0083 |
| 0.8 | 0.650 | 0.650 | 0.0075 |
| 0.9 | 0.700 | 0.700 | 0.0072 |
峰位误差不超过 0.005 m,整条曲线的平均绝对误差稳定在 $6\times10^{-3}$ 量级,与网络 32 个隐单元的表达能力相称。
手动选取测试点
换一个具体点核对:$c=0.4$、$t=0.5$ s、$x=0.25$ m。半秒内色点移动了 $c t=0.20$ m,所以这里的颜色应当接近起点 $x=0.05$ m 的值:
1 | speed = 0.4 |
输出:
网络预测 0.6556,手算颜色 0.6545
相对误差约 0.17%,量级与上表的平均误差一致。
规则网格采样对比
把随机采样换成固定的均匀网格,配置点数保持不变($8\times4\times4=128$):
1 | optimizer = torch.optim.Adam(net.parameters(), lr=0.002) |
运行输出:
| 步数 | 方程误差 | 初始误差 |
|---|---|---|
| 1 | 8.00e-03 | 8.03e-05 |
| 2500 | 6.06e-04 | 1.05e-04 |
| 5000 | 2.10e-05 | 7.05e-06 |
同样预测并可视化:
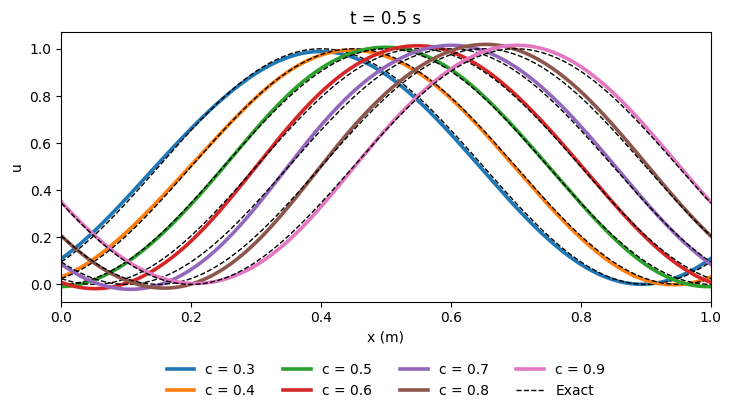
网格模型在训练点上拟合得更“紧”,曲线却更早偏离解析解。
| 带速 | 预测峰位 (m) | 手算峰位 (m) | 颜色平均绝对误差 |
|---|---|---|---|
| 0.3 | 0.400 | 0.400 | 0.0120 |
| 0.4 | 0.445 | 0.450 | 0.0065 |
| 0.5 | 0.500 | 0.500 | 0.0070 |
| 0.6 | 0.550 | 0.550 | 0.0136 |
| 0.7 | 0.600 | 0.600 | 0.0168 |
| 0.8 | 0.655 | 0.650 | 0.0160 |
| 0.9 | 0.705 | 0.700 | 0.0106 |
两种做法的对比很有意思:固定网格的训练损失低了将近两个数量级,但测试的平均绝对误差反而更大(多数波速下约为随机采样的 2 倍)。
固定网格为什么更差:经验风险与真实风险
PINN 求解偏微分方程的终极目标,是最小化整个连续域上的期望风险:
$$ \mathcal{L}_{\text{true}} = \int_{\Omega} \left\vert{} \frac{\partial u}{\partial t} + c \frac{\partial u}{\partial x} \right\vert{}^2 d\Omega = \mathbb{E}_{(x,t,c) \sim \mathcal{U}(\Omega)} \left[ \mathcal{R}^2(x,t,c) \right] $$
固定网格只用极少的点数($N=128$)构造经验风险:
$$ \hat{\mathcal{L}}_{\text{grid}} = \frac{1}{128} \sum_{i=1}^{128} \mathcal{R}^2(x_i^{\text{grid}}, t_i^{\text{grid}}, c_i^{\text{grid}}) $$
优化器能把 $\hat{\mathcal{L}}_{\text{grid}}$ 压到极低,但由于求积权重与采样密度不足,这个经验值已经严重脱离了真实的积分 $\mathcal{L}_{\text{true}}$。
动态随机采样属于随机逼近(Stochastic Approximation):每次迭代使用独立的蒙特卡洛小批量,梯度更新驱动模型朝全域连续积分的极小值方向前进。虽然单批次的随机波动使打印出来的损失停在 $10^{-4}$ 量级,但网络学到的是对整个连续解流形的稳健逼近,其对应的 $\mathcal{L}_{\text{true}}$ 远低于固定网格模型。
小结
- 把物理参数 $c$ 作为输入特征,一个网络就能覆盖整族解;归一化到 $[-1,1]$ 让
Tanh工作在灵敏区间。 - 用 $x \mapsto (\cos 2\pi x, \sin 2\pi x)$ 把周期边界写进输入,边界条件天然满足,无需惩罚项。
- 训练损失低不等于精度高:固定配点会让网络“背下”这些点,随机采样才是对连续域期望风险的逼近。